「effortは常にmaxにしろ」は本当なのか、実際に検証した
Claude Code の effort(AIにどれだけ考えさせるかの設定)は〝常に max にしろ〟。977いいねのこの助言を、そのまま設定に書き込んでよいのか。同じ課題を low〜max の4段階で動かし、答えの質・トークン・時間がどう変わるかを自分の手で測った記事。
今日も出し惜しみなしで、開発現場で得たものを全部書く。
今回は、「とりあえずeffortはmax」にしたまま、毎日数千円ぶんのトークンを静かに溝へ流していないか——そんな心当たりが少しでもある人に向けて書いた。
結論から言う。「effort(AIにどれだけ考えさせるかの設定)は常にmaxにしておけ」というアドバイスは、公式の説明と食い違っている。 それも977いいねという結構な数字がついた状態で流布している。今回はこれに実際に手を動かして、待ったをかけたい。
記事の要点は、文末の要点ダイジェストにQ&Aでまとめてある。
977いいねを集めた「effortは常にmaxにしろ」という投稿
Claude Code(Anthropicのコーディング支援ツール)には /effort という設定がある。AIにどれだけ深く考えさせるかを low / medium / high / xhigh / max の5段階(+Claude Code固有の ultracode)で選べる仕組みだ。
これが話題になった直後、Xでこんな投稿がバズった(実物のスクリーンショット。和訳を表示し、アカウント情報は伏せている)。
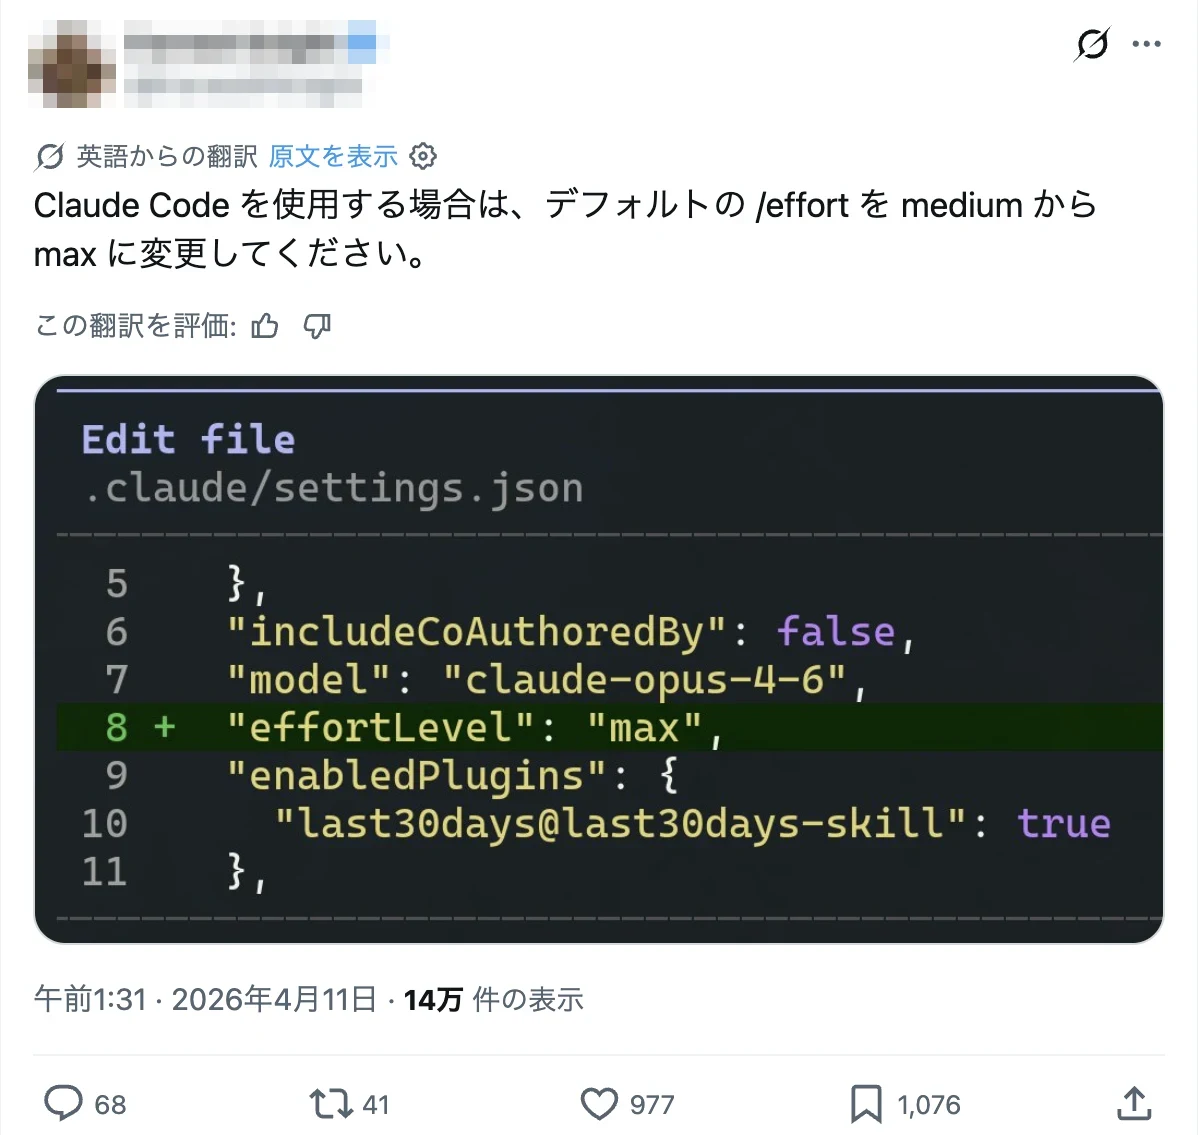
If you use Claude Code, change your default /effort from medium to max. (Claude Codeを使っているなら、デフォルトのeffortをmediumからmaxに変えろ)
添付されていたのは .claude/settings.json の差分スクリーンショットで、"effortLevel": "max" を追記する内容。投稿は977いいね・14万インプレッション・68件の返信という拡散力を見せている。
ここは責めるところではない。いちばん強そうなオプションに逃げたくなる気持ちは分かる。
でも、Anthropic公式のeffort解説は逆を向いている
Anthropicの公式ドキュメント(Claude Platform Docsの「Effort」ページ)を確認すると、5段階はこう説明されている。
| effort | 位置づけ | 向いている場面 |
|---|---|---|
| low | 最も効率的。token(AIが処理する文章の単位)を大幅に節約。能力はやや抑えめ | 単純なタスク |
| medium | 速度・コスト・性能のバランス型 | 汎用的なタスクの主力 |
| high | 高能力。何も指定しない場合と全く同じ挙動 | 複雑な推論・難しいコーディング・通常のエージェント作業 |
| xhigh | 長時間タスク向けの拡張能力(対応は新しめのモデル限定) | 30分以上・数百万token規模の探索 |
| max | token消費の制約を外し、最大限の推論 | コスト度外視で最も徹底した分析をしたい場面 |
つまり公式のポジションは「highはデフォルトと同じ、大半の複雑な作業に対する強い標準解」であり「xhigh/maxはより狭い、コストと引き換えの特殊用途」。「highは弱いから常にmax」という理解とは、そもそも軸が違う。
ここまでは公式ドキュメントを読めば誰でも分かる話だ。問題は、それが実際の挙動でも本当にそうなっているか。ドキュメントの言葉を信じるだけでは、977いいねの実感と平行線のままになる。だから今回は、自分の手元で実際に動かして確かめた。
実際に検証した ── 同じタスクをeffort low〜maxの4段階で動かす
やったことはシンプルだ。全く同じプロンプトを --effort low/medium/high/max の4通りで実行し、出てきた答えの正しさ・出力トークン数・所要時間・コストを実測して比較した。 モデルは固定(Claude Sonnet 5)、ツール呼び出しは無効化(純粋な思考の差だけを見るため)、会話履歴なしの単発実行。各条件1回ずつの実測(N=1)なので、数十トークン単位の揺れはある前提で読んでほしい。それでも傾向ははっきり出た。
検証1: バグ発見タスクでeffort4段階を実測比較
以下の moving_average(移動平均)関数には、目立たない境界値バグ(window 個未満しか要素が集まっていない先頭部分でも常に window で割ってしまう)が仕込んである。「バグを1つ指摘して、直し方を一言で」という指示で4段階に投げた。
| effort | 正誤 | 出力トークン | 所要時間 | コスト(USD・出力分) |
|---|---|---|---|---|
| low | ✅ 正解 | 209 | 9.2秒 | $0.003 |
| medium | ✅ 正解 | 642 | 15.9秒 | $0.010 |
| high | ✅ 正解 | 414 | 9.7秒 | $0.006 |
| max | ✅ 正解 | 2,448 | 30.9秒 | $0.037 |
4段階すべてが同じ結論(start = max(0, i - window + 1) に直せ)にたどり着いた。正答率は変わらないのに、maxはlowの約12倍のトークンを使い、所要時間も3倍以上かかっている。
コスト列は出力トークン分のみ($15/100万トークンで換算)を載せている。実際の請求額には、毎回まっさらな claude -p セッションが Claude Code の初期設定一式(約2.7万トークン≒$0.16)を読み込む入力側の固定費が乗り、そちらが総額を支配してeffortの差が見えなくなってしまうからだ。effortで変わるのは出力側——「考えた長さ」の差は、この出力分コスト(=トークン量に比例)にそのまま現れる。
検証2: 論理パズルでeffort4段階を実測比較
もう1問、9個の制約から住人とペットの組み合わせを一意に特定する論理パズル(あかり・けんじ・ゆい・そらの4人が家1〜4番に住み、犬・猫・鳥・魚を飼う)を解かせた。答えが一意になることは事前にPythonで総当たり検証して確認済み。
| effort | 正誤 | 出力トークン | 所要時間 | コスト(USD・出力分) |
|---|---|---|---|---|
| low | ✅ 正解 | 383 | 13.8秒 | $0.006 |
| medium | ✅ 正解 | 502 | 13.2秒 | $0.008 |
| high | ✅ 正解 | 781 | 14.6秒 | $0.012 |
| max | ✅ 正解 | 1,363 | 16.0秒 | $0.020 |
ここでも4段階全部が正解。トークン数はlowからmaxへほぼ単調に増え、約3.6倍まで膨らんだ。
検証3: カットオフ後の数学オリンピック問題でも差は出ないのか
ここまでの2問には「訓練データで見たことのある類題を思い出しているだけでは?」という疑いが残る。そこで、モデルが原理的に暗記できない問題——学習データの期限(カットオフ=2026年1月)より後、2026年2月に出題された数学オリンピック系コンテスト AIME 2026 I の Problem 8(整数論・公式解答は244)——で同じ4段階を回した。
| effort | 正誤 | 出力トークン | 所要時間 | コスト(USD・出力分) |
|---|---|---|---|---|
| low | ✅ 正解 | 894 | 10.8秒 | $0.013 |
| medium | ✅ 正解 | 1,158 | 12.9秒 | $0.017 |
| high | ✅ 正解 | 1,667 | 17.7秒 | $0.025 |
| max | ✅ 正解 | 7,838 | 63.8秒 | $0.118 |
結果は同じだった。暗記が効かない初見の数オリ問題でも、lowが11秒で正解し、maxは8.8倍のトークンと5.9倍の時間をかけて同じ244にたどり着いた。 ここでもトークンはlowからmaxへ単調に増え、maxだけが突出して跳ね上がる——検証1・2とまったく同じパターンだ。
実測結果: effortを上げても正答率は変わらなかった
- 少なくともこの3タスクでは、effortを上げても答えの質は変わらなかった。単に長く考えて、長い説明を書いて、時間とtokenを多く使っただけだった
- 検証3はカットオフ後の出題なので「暗記していた類題を思い出しただけ」という説明も成り立たない。初見の数オリ問題を、lowが11秒で解いている
- しかもトークン増加は段階的ではなく、maxだけ突出して跳ね上がる(検証1ではhigh→maxで約6倍)。これは公式ドキュメントの「maxはコストと引き換えの特殊用途」という位置づけと整合する
- 逆に言えば、このレベルの難易度のタスクなら
lowで十分、というのも実測で言える。今回の2問はどちらも「1回の応答で完結する、境界値を意識すれば解ける」程度の難易度だったので、これより桁違いに難しい・探索が必要なタスクではhigh以上が効いてくる可能性はある(そこは公式の言う通り)。ただ「とりあえずmax」でその差が自動的に埋まるわけではない、ということは今回の数字がはっきり示している
effortとは何の設定か ── 〝本気度〟ではなく思考リソースの配分
これはオーケストラの指揮者の仕事に近い。良い指揮者は静かなパートでは音量を絞り、盛り上げるべき箇所だけ全奏に持っていく。常に最大音量で振れば良い演奏になる、ということはない。
effortも同じ構造をしている。「本気度を最大にする」設定ではなく、「このタスクにどれだけの思考リソースを割り当てるか」を人間が決める配分の設定だ。今回の実測が示す通り、typo修正やちょっとしたバグ探しにmaxを使うのは、ピアニッシモの箇所でシンバルを鳴らすようなものだ。
effortの使い分け ── low/medium/high/xhigh/maxの選び方
公式の説明と、今回の実測を合わせるとこうなる。
大事なのは、maxが「上位互換」ではないという点だ。今回の実測でも、typo修正レベルのタスクにmaxを使ったところで、lowと同じ答えが最大12倍のトークンと3倍超の時間をかけて返ってくるだけだった。Agenticな皆さんの日常タスクなら、デフォルト同等のhighで十分すぎる——むしろ単純作業が続く日は、lowに落とす方が実質の勝ち筋になる。
digest
疑問解消のための要点ダイジェスト
開く ▾
Q. 「effortは常にmaxにしろ」は結局正しいの?
実測では支持されなかった。バグ発見・論理パズル・カットオフ後の数学オリンピック問題(暗記不可能)の3タスクをlow〜maxの4段階で動かしたところ、正答率は全段階同じで、maxはlowの3.6〜12倍のトークンと最大5.9倍の時間を使っただけだった。公式もmaxを「コスト度外視の特殊用途」と位置づけている。
Q. 結局、普段はどのeffortにしておけばいい?
迷ったらhigh(=デフォルトと同じ挙動)のままでいい。単純作業が続くならlow/mediumに下げ、maxは「コストを払ってでも徹底的に」という重要判断に絞る、というのが公式の説明と今回の実測を合わせた読み。
Q. effortはどこで設定する?
セッション中は /effort コマンドで切り替えられる。恒久的に変えるなら settings.json の effortLevel、CLIの単発実行なら --effort フラグ。今回の検証は --effort で行った。
Q. モデル選択(Sonnet/Opusなど)とeffortはどう違う?
モデル選択は「どの頭脳を使うか」、effortは「その頭脳にどれだけ考える時間を割り当てるか」。別々のつまみで、掛け算で効く。迷う場面では、まずタスクの難しさがどちらの軸の問題かを考えるといい。
Q. maxが本当に活きるのはどんな場面?
探索範囲が広く、1回の応答では決着しないような難問だと思う。今回のような「1回の応答で完結するタスク」では差が出なかった、というのが実測の示すところ。
この話の本当の論点 ── バズった助言は自分の手で検証する
977いいねという数字は、それ自体が「正しさ」の証明にはならない。バズった投稿と公式の一次情報が食い違ったとき、どちらを信じるかは、自分で検証するしかない。 今回は公式ドキュメントを読むだけでなく、実際に4段階×3タスク(うち1つはカットオフ後の数学オリンピック問題)を動かしてトークン数まで数えた。結果、「常にmax」という助言は、少なくとも今回試した難易度のタスクでは支持されなかった。
AIツールは今後も次々に新しい設定・新しい概念を出してくる。effortという名前も5段階という区切り方も、来年には変わっているかもしれない。でも「拡散力のある助言を、実際に手を動かして検証してから使うか」という判断の習慣は、ツールが変わっても残る。小手先の設定値は来年変わる。確かめ方は10年もつ。 今回はたまたまeffortの話だったが、こういう「SNSの暴論に、実測データで反論する」ネタは今後も続けていくつもりだ。